Arstruct編集部
現場で使われるAI活用とサービス開発の実務情報をお届けします
2026年10月の2週間で、OpenAI・Google・Microsoftの三社が揃ってモデル更新とエージェント機能強化を集中的に実施した。GPT-6(Sol/Luna)が10月7日に全プランへ展開されてGPT-5.6を置き換え、Gemini 4 Argon(gemini-4-argon)が10月13日に正式版(GA)としてリリースされ、Microsoft 365 CopilotにはAIチャット統合とResearcherモデル選択機能が10月6日に追加された。これだけ聞くと「今すぐ切り替えなければ乗り遅れる」という焦りが生まれる。しかし、その焦りに乗って急いでツールを入れ替えた組織が、2週間後にどうなるかは予想できる。
問題はモデルの性能でも選定タイミングでもない。既存の業務フローとデータ整備が放置されたまま新しいモデルを接続しても、AIが参照する情報が断片化しているため、出力もまた断片化する。「前のやり方の方が速い」という現場の声は、AIへの抵抗ではなく、受け側の設計が追いついていないことへの正確な評価だ。この記事では、ツール選定より先に整えるべき業務フローの詰まりを分解し、生成AIに任せてよい範囲と人間が判断すべき範囲を切り分ける。最初の2週間で何を検証すべきかを、具体的な順序で示す。
1.「使えるモデルが増えた」という認識が、既存業務の未整理を隠す
Gemini 3.7/3.5 Flashは2026年10月8日に非推奨化され、後継モデルへの自動ルーティングが始まった。同時期にGemini APIのDeep Research Agent(deep-research-pro-preview-12-2025)は10月23日のシャットダウンが告知されており、プロダクション環境で使っていた組織は対応を迫られている。これは「便利なツールが増えた」という文脈ではなく、使っている機能が突然廃止されるリスクが現実になったという文脈で読む出来事だ。
AI調達環境はすでに「どれを選ぶか」から「継続的にどう再評価するか」のフェーズへ移行している。この局面で既存システムとの接続設計を特定ベンダー依存で構築していた組織は、廃止告知のたびに移行コストを払い続ける。一方、業務フローを先に整理し、モデルを差し替え可能な設計にしていた組織は、非推奨化をシステム変更ではなく設定変更として処理できる。差がつくのはモデルの選定眼ではなく、既存業務の整理度合いだ。
放置した場合と整理した場合の違い
- データが散在したまま導入:AIの出力を毎回人間が修正し、確認工数は減らない
- 業務フローを先に整理:AIが参照する情報が一元化され、出力の精度が安定する
- 現場教育なしで展開:担当者がプロンプトを試行錯誤し、ツールを使わなくなる
- 入力ルールを先に決める:アウトプットのばらつきが抑えられ、レビュー工数が減る
Gartnerの「2026年CIO/テクノロジ・エグゼクティブ・サーベイ」は、日本企業の課題を「導入したかどうか」ではなく「導入した成果を全社の価値に変えられているか」と指摘している。成果が出ない理由の多くはモデルの性能ではなく、受け側の業務設計にある。新技術が週単位で更新される今こそ、ツール選定を急ぐより業務フローの整備を優先すべき局面だ。
2.確認待ちと手戻りが現場の時間を食い続けている。ツールが入っても変わらない理由
AI導入の話が出たとき、現場から最初に出る課題は「どのツールを使えばよいか分からない」や「入力が面倒」だ。しかし業務を分解すると、時間を最も消費しているのは入力作業ではなく、確認待ちと手戻りの連鎖だ。判断基準が文字化されていないため、担当者は上長に「これどうしますか」と確認し、上長は別の判断者に問い合わせる。差し戻し後に修正し、再確認する。このループはAIを導入しても消えない。なぜなら、ループの原因は入力作業の非効率ではなく、判断基準の属人化にあるからだ。
たとえば顧客からの問い合わせ対応を例にとると、一次回答の作成に1件あたり15分かかり、月40件対応するなら月10時間が一次回答だけで消える。さらにエスカレーションの判断基準が曖昧な場合、担当者が上長に確認する時間が別途発生する。この確認が1件あたり10分で月20件あれば、月3時間以上が承認待ちに溶けている。合計13時間以上が、記録にも残らない確認作業に費やされている計算だ。生成AIで一次回答を自動化しても、エスカレーション基準が曖昧なままなら、この損失の大半は削れない。
「誰が確認したのか分からない」という状態が日常的に起きている工程を探せば、AI導入より先に整理すべき業務フローの詰まりが見える。記録されない判断は、担当者が変わったときに業務停止を引き起こす。これは手戻り工数の問題だけでなく、担当者退職時の業務継続リスクでもある。現状維持によって失っているのは時間だけでなく、引き継ぎの確実性と顧客対応の品質だ。データ整備が手付かずのまま新しいモデルを接続しても、返信遅延と手戻り工数はむしろ増える可能性がある。
3.AIに任せてよい範囲を断言する。そして、絶対に任せてはいけない判断がある
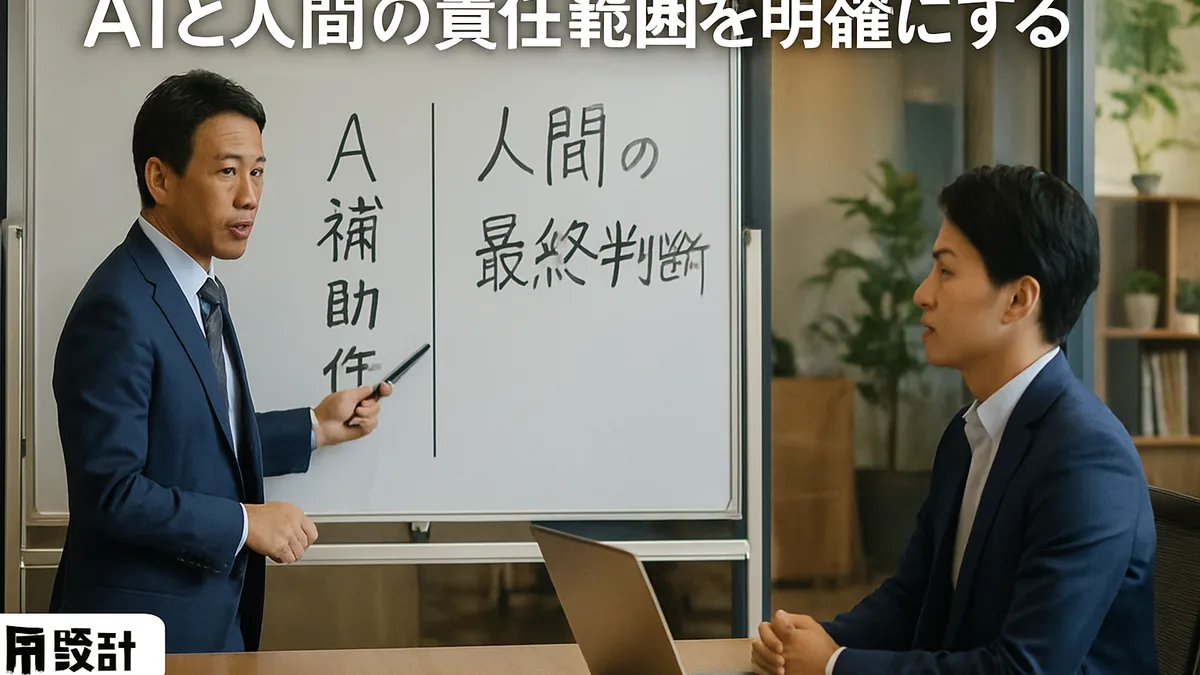
AIに任せてよいのは、記録・整理・下書き・候補抽出・要約・検知など、補助作業に限る。具体的には、問い合わせの一次回答ドラフト作成、過去データからのFAQ候補抽出、社内ドキュメントの要約、コード初稿生成(Codexが担う領域)、複数モデルの出力比較材料の作成などが該当する。これらはAIが担うことで、担当者が判断に使える時間を確保できる。
一方、AIに任せてはいけない判断がある。顧客への謝罪方針、返金可否、例外承認、情報公開の最終決定、採用合否、契約内容の確定。これらは人間が責任を持つ範囲だ。理由は明確で、AIの出力は過去データのパターンを反映するため、個別の事情や組織の価値判断を正確に反映できない。顧客や取引先への説明責任は組織に残る。AIが生成した謝罪文をそのまま送って問題が複雑化した場合、誰が説明するのかという問いに答えられなくなる。これは抽象的な論議ではなく、問い合わせ対応でAIに謝罪方針まで任せるべきではないという実務上の判断だ。
やめた方がいいAI活用として、明確に挙げておく。複数の業務工程にAIを一気に導入するのは危険だ。たとえば問い合わせ対応でFAQ整備・チャットボット導入・有人対応ルール・エスカレーション条件を同時に変えると、回答品質を誰も確認しなくなる。なぜ止まるかというと、確認責任が分散するからだ。AIの出力が正しいかどうかをレビューする担当者が決まっていない状態で複数工程を同時に変えると、「結局Slackで聞いている」状態が再現し、AIは飾りになる。1工程ずつ導入し、その工程の確認者と更新ルールを決めてから次に進む順序が、現場で使われ続ける形を作る。
料金や費用面では、各社の公式料金ページでの個別確認が必須だ。OpenAI・Google・Microsoftが同時期に大型更新を行っている今、料金体系も変動している。今回確認できた公式ソース(openai.com、AI.google.dev/gemini-API/docs/changelog)の範囲では具体的な単価数値は明示されておらず、API利用費用は利用モデル・リクエスト数・コンテキスト長によって大きく変わる。複数ベンダーへの分散利用を前提とした利用上限設定と請求管理が、コスト暴走を防ぐための実務判断になる。
4.最初の2週間で検証すべきは、1工程だけを選んで確認者を1人に決めることだ
AI導入で最初にやるべきことは、モデル選定でも料金比較でもない。業務フローの中で「AIが出力を補助し、人間が最終確認する」という境界を引ける工程を1つ選ぶことだ。工程選定の判断基準は3点ある。入力データが一元化できているか、確認者を1人に決められるか、1週間以内に出力の良否を判定できるか。この3点を満たす工程から始める。
失敗パターンとして、よく起きる構造を示す。社内で「生成AIを活用しよう」という機運が高まり、営業資料作成・社内FAQ・問い合わせ対応・月次レポートをまとめてAI化しようとする。結果、どの工程もプロンプトが固まらず、出力のレビュー担当が決まらず、2週間後には誰も使っていない。なぜ止まるかというと、現場教育と確認フローを設計しないまま複数工程を同時に変えたからだ。既存システムとの接続方法も未定のまま進めた結果、担当者が個別に試行錯誤を始め、ツールごとのルールが乱立する。これは大企業だけの話ではない。担当者が2〜3名しかいない組織でも、同じ構造で止まる。
先送りした場合の損失は、手戻り工数・返信遅延・月次締め遅延として積み上がる。さらに、Gemini APIのDeep Research Agentのように使っているモデルや機能が突然シャットダウン予定として告知される事態は現実に起きている。特定サービスへの依存を前提とした運用設計の見直しは、新しい技術を入れるかどうかの話ではなく、既存業務フローのリスク管理として経営判断が問われる場面だ。
弊社で相談を受ける場合、最初に確認するのは「現在の業務フローで、入力データが一元化されている工程はどこか」と「その工程の確認者は誰か」の2点だ。この2点が答えられれば、最初の2週間で検証すべき1工程が決まる。業務フローの整理、AI活用箇所の選定、プロトタイプの設計、運用ルールの策定、現場で使われ続ける形への落とし込みを、この順序で支援している。次のアクションは、自社の業務フローの中で「確認者が1人に決まっていない工程」を今日1つ書き出すことから始まる。
既存のSlackやExcel運用と二重管理にならないか
二重管理になるかどうかは、AIツール導入前に既存の記録場所を一本化できるかどうかで決まる。SlackとExcelに分散したまま新ツールを加えると三重管理になる。先にどのデータをどこに集約するかを決め、既存ツールへの入力をやめる工程を明示してから導入する順序が二重管理を防ぐ。
モデルが次々に更新されるなか、今選んだツールがすぐ使えなくなるリスクはどう考えるか
実際のリスクとして、Gemini APIのDeep Research Agentが2026年10月23日にシャットダウン予定として告知されているように、使用中のモデルや機能が廃止されることは現実に起きている。対策は特定ベンダー1社への依存を前提とした設計を避け、切り替え可能な設計を用意しておくことだ。料金や仕様の変更は各社公式ページで定期確認し、プロダクション利用中のモデルの非推奨情報を見逃さない運用ルールを社内に設ける。
AI導入の費用対効果をどう判断すればよいか
費用対効果の判断は、削減できる確認工数と手戻り工数を先に計算してから料金と比較する順序が正確だ。たとえば確認作業に月10時間かかっている工程があれば、その時間の人件費と導入費用を比較する。料金は利用モデル・リクエスト数・コンテキスト長によって変動するため、各社公式ページで個別に確認し、仮定の月次利用量で試算してから判断する。
現場担当者がAIの出力を信用しない場合はどうするか
出力を信用しない原因の多くは、入力データの品質が低いか、確認フローが決まっていないかのどちらかだ。まず入力データを整備し、AIの出力を下書きとして扱い人間がレビューして確定するフローを明文化することで信頼が積み上がる。最初から出力をそのまま使わせようとするのではなく、AIが候補を出し担当者が選ぶという形で導入すると現場の抵抗が下がる。
無料相談Free consultation
まず、どの業務で詰まっているかを
一緒に整理します。
ツール選定の前に、業務フロー、判断基準、記録が残っていない工程を確認します。
要件が固まっていない段階でも構いません。