
ベンチマーク
Benchmark Score
AI用語解説Overview
AIモデルの性能を数値で測る指標のこと。各社が発表するスコアで回答精度や処理速度などを比較できるが、自社業務への適合度と必ずしも一致しない点に注意が必要。
さらに詳しく解説Details
AIモデルベンチマークスコアとは、AIの能力を客観的に比較・評価するために使われる標準的なテストの得点のことです。学校のテストと同様に、各AIモデルが決められた問題セットに答え、その正答率や品質が点数化されます。
代表的なベンチマークには、数学的推論を測る「MATH」、論理・常識を測る「MMLU」、プログラミング能力を測る「HumanEval」などがあります。各AIプロバイダーは新モデルをリリースする際にこれらのスコアを公表し、性能をアピールしています。
ただし、ベンチマークスコアはあくまで標準的なテストでの成績であり、実際の業務での使いやすさとは異なる場合があります。例えば「数学のスコアが高いモデル」でも、日本語の敬語表現や業界特有の専門用語への対応が弱いケースもあります。モデル選定の際はスコアを参考にしつつ、実際の業務シナリオでの動作検証(PoC)を行って自社に合ったモデルを選ぶことが重要です。
関連用語Related terms
この用語が登場した記事Related articles9件
生成AI最新動向を追いながらツールを選べない組織は、業務の詰まりを言語化する前に比較表を作っている
Claude・Gemini・OpenAIが2026年11月に相次いで価格改定とエージェント機能を投入した。生成AI最新動向を把握する前に、自社のどの工程が詰まっているかを言語化しないと、ツール選定の判断は永遠に後回しになる。
生成AI最新動向を追うだけでは損をする。モデル更新と料金変更を業務判断に変える問いの整理
生成AI最新動向の変化速度が上がるほど、情報収集だけで終わる組織の損失も静かに積み上がる。料金変更・モデル更新・利用制限の影響を自社業務に戻さなければ、コスト再評価の機会は毎月失われていく。
生成AI最新動向を追うより、業務影響を3軸で整理せよ
GPT-5.6 Solの値下げ、gpt-6-cyberのAPI公開、Dotsの企業向けGA。生成AI最新動向は週単位で動いている。追うだけでは投資判断は進まない。業務影響の優先順位を先に決めた組織だけが、試す工程を間違えずに済む。
生成AI 最新動向に振り回される比較表の誤解。ツール選定より先に業務の詰まりを特定せよ
生成AI 最新動向を追いかけてツールの比較表を作成しても、現場の業務課題を特定しなければ成果は出ません。本記事では、モデル選定や乗り換え判断で陥りがちな失敗を防ぎ、責任境界を設定して現場で使われる運用フローを構築する手順を解説します。

サイバーセキュリティ最新動向を追うより先にLLM乗り換え判断の基準を揃えよ
サイバーセキュリティ最新動向や主要LLMのモデル更新を追うだけでは現場は変わりません。ChatGPT、Claude、Gemini、Grokの機能比較ではなく、料金・利用制限と業務影響に基づく乗り換え判断を策定し、確認待ちと二重コストを削減する運用設計を解説します。
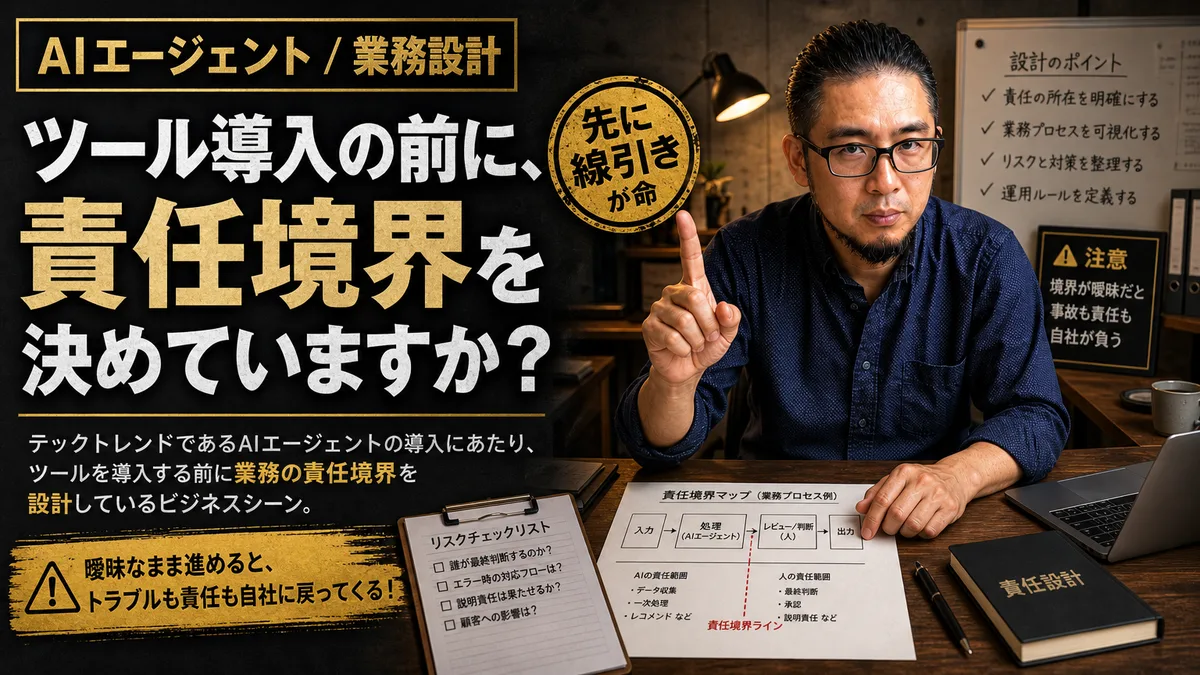
テックトレンド追従の罠。AIエージェント導入で崩壊しないための責任境界設計
テックトレンドの波に乗り遅れまいとAIツールを導入しても、現場の二重管理で破綻するケースが後を絶ちません。AIへの業務委任範囲と人間が最終確認する承認フローの境界設計が必要です。実務で機能する具体的な判断基準と手順を解説します。
テックトレンドに乗り遅れない2週間PoC。競合に埋もれない優先業務の絞り込み方
他社の成功事例を待つ「様子見」は、競合との格差を広げる致命的なリスクです。本記事では、最新のテックトレンドを自社の優先業務へ落とし込み、2週間で検証するための判断基準を解説。ツール選定で迷う前に、どの工程でPoCを回すべきかを伝えます。
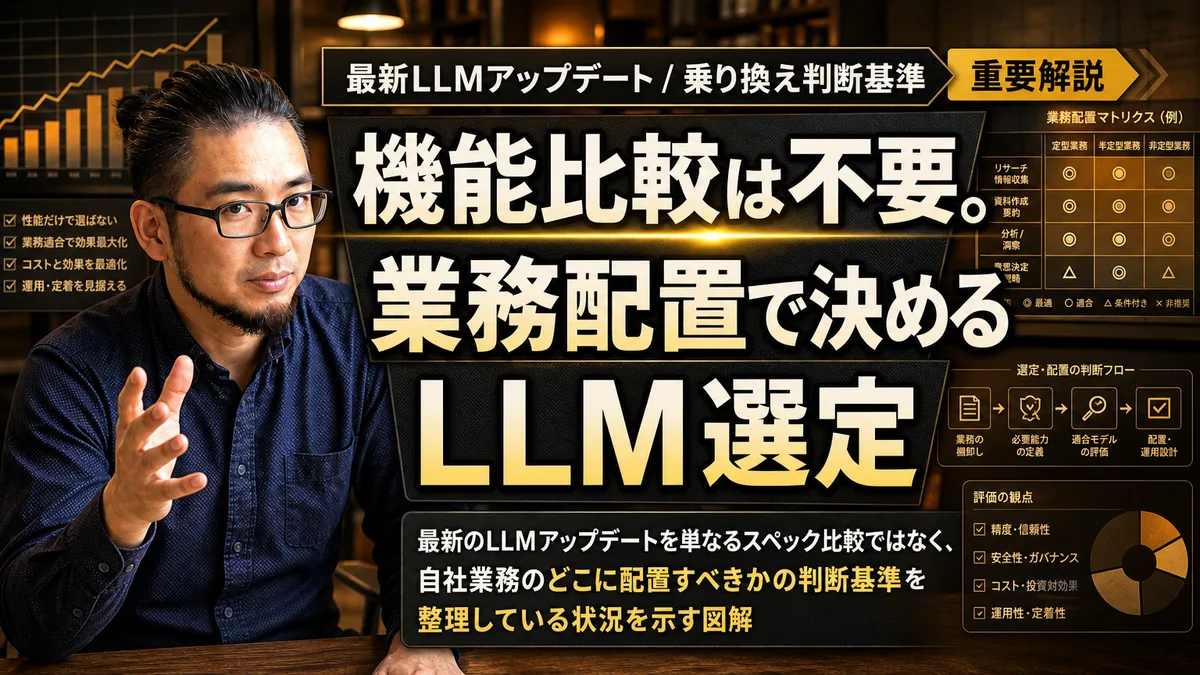
LLMの機能比較で満足する組織は、モデル更新の波にのまれて現場の運用が崩壊します
主要LLMの頻繁なアップデートに対し、スペック表を眺めるだけの対応は無駄です。モデル更新や料金改定が相次ぐ中、自社業務のどこを切り替えるかの判断基準がない組織は、現場の混乱と不要なコスト増を招きます。実務に即した乗り換え判断の設計を解説します。

最新AIを「まだ早い」と静観する会社は、導入時期より試す領域を間違えている
最新のテックトレンドを追うだけで、自社の優先業務を決められない企業は多い。他社の動きを待つ静観姿勢が招く商談機会損失や確認待ち時間という損失を明らかにし、競合に先駆けて試すべき領域を見極めるための実践的な判断基準を解説する。